核心结论
AnchorDiT 研究的是像素空间扩散模型中一个基础且尚未被充分解决的问题:同一 patch 粒度很难同时兼顾全局语义、局部细节与计算效率。大 patch 能以较短序列稳定建模对象和布局,却会损失边界与纹理;小 patch 保留了高频信息,却使 token 数量以及全局自注意力开销迅速增长。论文将这一矛盾概括为 granularity dilemma,并提出一套围绕该问题完整展开的解决方案。
AnchorDiT 的主要创新体现在面向这一问题的系统级协同设计:cross-attention、SA-RoPE 与 register token 被组织成一个逻辑闭环:
由大尺度分支提炼多层语义锚点,由小尺度分支保留像素级细节,再通过具备几何对齐能力的 Anchor Connector,让每个细粒度 token 在生成过程中持续查询经显式监督的稠密语义。
这一设计避免让冗余的细粒度 token 独立承担昂贵的全局建模任务,同时不引入 VAE/RAE 生成路径中的额外重建误差。论文在 ImageNet 256×256 和 512×512 上给出了主结果、组件消融和表征可视化,形成了从研究动机、架构设计到实验证据较为完整的论证链。
1. 为什么这个问题重要?
主流高分辨率扩散模型通常先用 VAE 将图像压缩到潜空间,再进行生成。潜空间建模显著降低了计算量,但 VAE 的有损压缩会引入额外的信息瓶颈和重建误差,部分高频纹理、细小结构与精确边界可能在这一过程中丢失。像素空间扩散直接建模自然图像分布,因此具有绕开该重建误差通道的潜力。
然而,像素空间 Transformer 对 patch size 极其敏感。若 patch 边长缩小为原来的 1/n,token 数量会增加到 n2 倍,完整 self-attention 的计算量则会增长到约 n4 倍。于是模型面临一个结构性矛盾:
- 大 patch 序列短、全局建模高效,但空间粒度不足;
- 小 patch 细节充分,但大量相邻像素 token 高度冗余,完整全局注意力代价过高。
AnchorDiT 的出发点因此具有明确的研究意义:问题不是简单选择一个更好的 patch size,而是重新分配“全局理解”和“细节生成”的计算职责。
2. Anchor-Guided Cross-Scale Interaction
AnchorDiT 采用非对称的双流结构:
- Semantics Flow 使用大 patch 和较短的 token 序列,通过堆叠的 DiT blocks 提取全局结构及多层语义;
- Fine-grained Flow 使用小 patch 保留边界、纹理和细小部件所需的空间分辨率;
- Anchor Connectors 在网络的多个深度连接两条流,将 Semantics Flow 的中间表征作为 semantic anchors 传给细粒度分支。
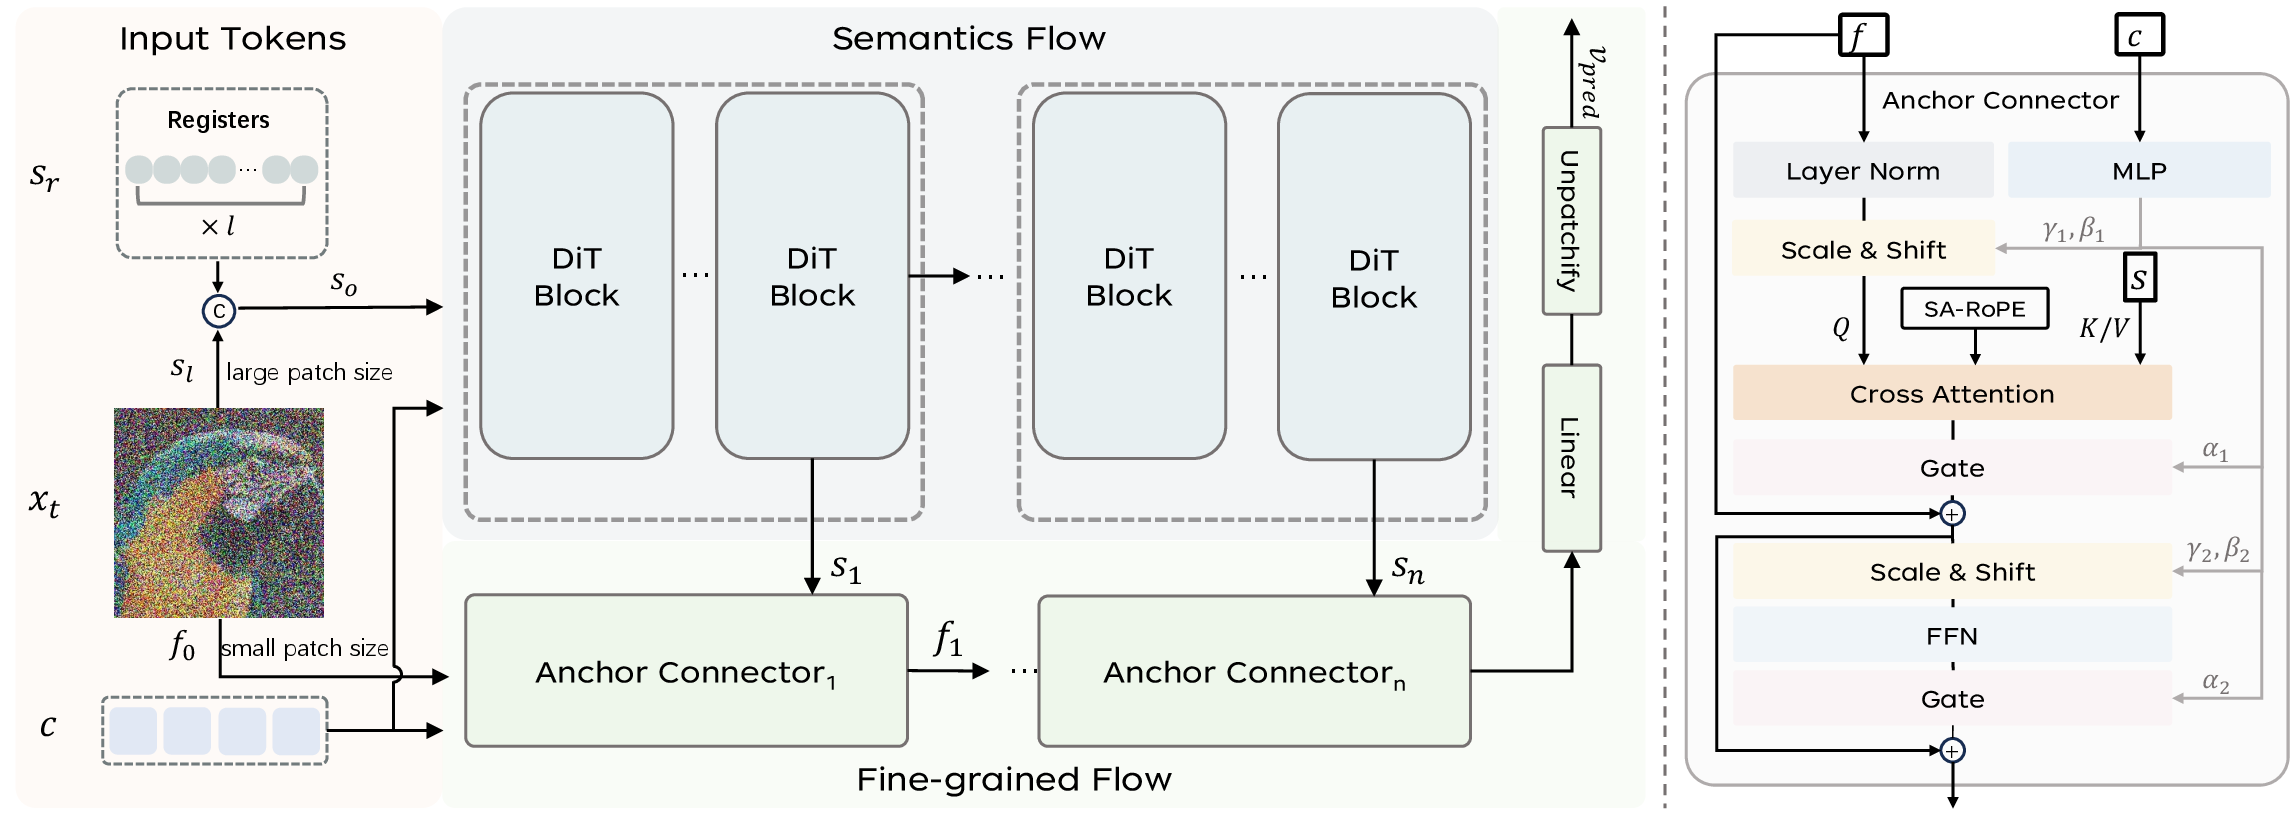
图 2:AnchorDiT 整体架构。上方 Semantics Flow 以大 patch 和 registers 提取多层语义锚点 si;下方 Fine-grained Flow 保留小 patch 特征 fi,并在不同深度通过 Anchor Connectors 查询对应锚点。右侧展示了单个 Connector 内部由 SA-RoPE 对齐的 cross-attention、条件门控和 FFN。
在第 i 个 Anchor Connector 中,细粒度特征 fi-1 产生 query,来自 Semantics Flow 的语义锚点 si 产生 key 和 value:
Q=WQ· AdaLN(fi-1), K=WKsi, V=WVsi,
fi=fi-1+α1· CA(Q,K,V).
因此,每个细粒度 token 都可以根据自身位置与当前生成状态,主动选择相关的全局语义,而不再仅依赖 AdaLN 式跨流调制。由于 key/value 来自紧凑的大 patch 序列,核心序列交互项由完整细粒度自注意力的 O(Nf2 d) 转为 O(Nf Na d);当语义锚点数 Na 明显小于细粒度 token 数 Nf 时,这种设计能以更可控的成本提供全局感受野。这里描述的是 cross-attention 的主要交互项,而非模型总计算量;Semantics Flow 的 self-attention、线性投影和 MLP 仍会产生额外开销。
这一区别构成了 AnchorDiT 相对已有多流方法的核心创新:它不是仅在两条分支之间传递一个全局调制信号,而是建立细粒度 token 到多层语义锚点的、逐 token 且内容自适应的查询关系。
3. 三项设计形成技术闭环
3.1 多层 Anchor Connectors:让语义指导贯穿生成深度
AnchorDiT 并非只在网络入口或末端进行一次特征融合,而是从 Semantics Flow 的不同深度抽取 s1,…,sn,并依次指导 Fine-grained Flow。这样,细粒度分支可以随着主干表征的演化反复获得语义指导,而不是依赖单次、静态的语义注入。
消融结果支持这一设计。在语义主干固定为 24 个 DiT blocks 时,将 Anchor Connector 数量从 2 个增加到 4 个,FID 从 3.76 降至 2.07,IS 从 231.0 提升至 271.4。继续增加到 6 个时,FID 仅小幅改善到 2.03,IS 则回落至 269.6,同时参数量由 676M 增加到 724M,说明 4 个连接器已经取得很好的质量—容量折中。尽管连接器数量与参数量同步变化,这一趋势仍与论文的核心假设一致:在网络不同深度持续提供语义锚定,有利于细粒度生成。
3.2 SA-RoPE:缓解跨尺度注意力中的几何错位
标准二维 RoPE 通常在各自的 token 网格中使用离散行列下标。同一个索引,例如 (0,1),在大 patch 与小 patch 网格中可能对应完全不同的图像区域;若直接进行 cross-attention,位置编码反而会给跨尺度匹配引入冲突。
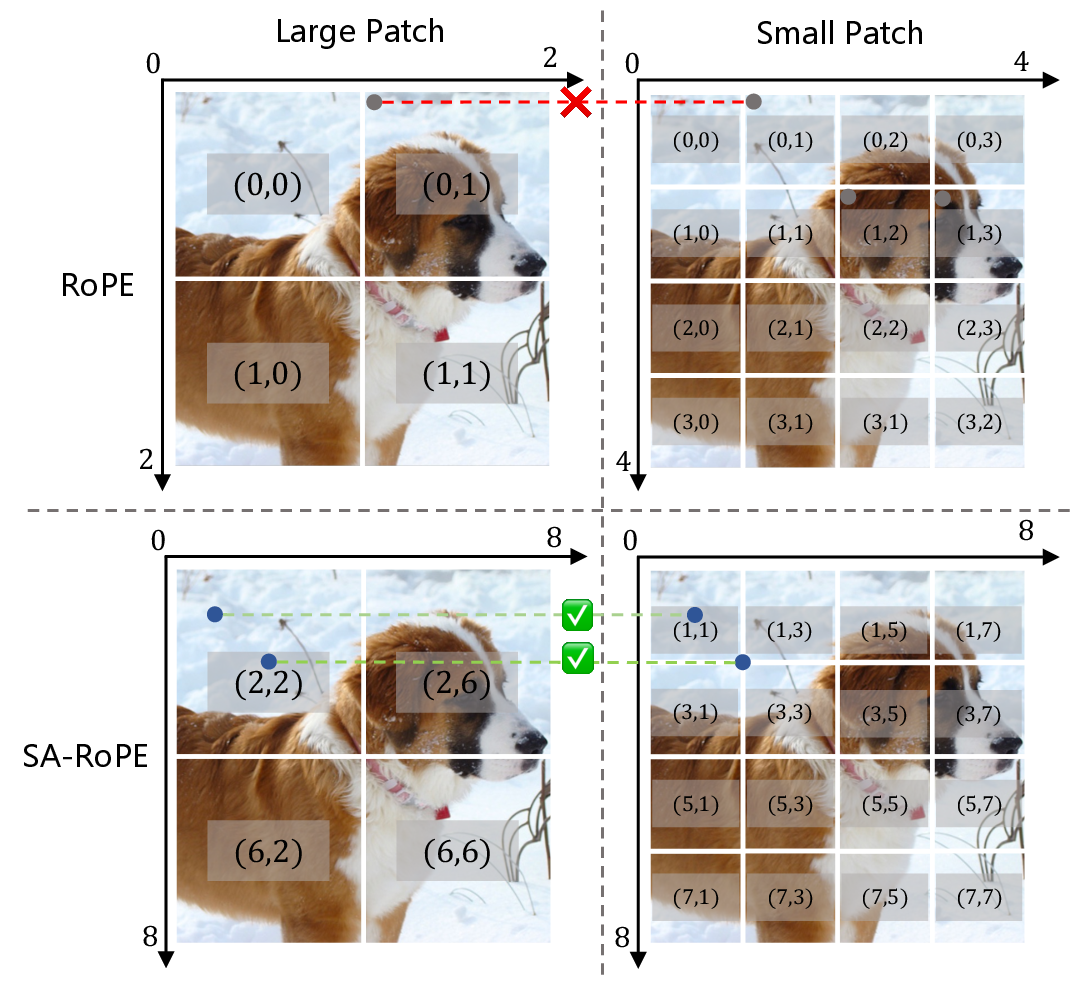
图 3:标准 RoPE 与 SA-RoPE 的对比。上半部分中,相同网格下标在大小 patch 上指向不同物理区域;下半部分中,SA-RoPE 使用 patch 中心和共享坐标,使跨尺度 token 的相对位置可以直接比较。
Scale-Aware RoPE(SA-RoPE)将不同尺度 patch 的中心点映射到统一坐标系。对于 patch size 为 p、原网格位置为 (i,j) 的 token,其新坐标为:
i'=(ip+p/2)/pbase, j'=(jp+p/2)/pbase.
这样,query 与 key 的相对位置由它们在图像中的真实物理距离决定,而不是由两套互不兼容的网格编号决定。SA-RoPE 并非游离于主线之外的通用技巧,而是使 Anchor Connector 能在可比较的物理坐标中进行跨尺度注意力的针对性设计。组件消融中,加入 SA-RoPE 后 FID 从 2.24 降至 2.19,尽管 IS 从 264.7 略降至 263.2,FID 的改善仍为该几何动机提供了定量支持。
3.3 VFM-supervised Registers:解耦语义表征与空间去噪
Semantics Flow 中的大 patch token 同时包含扩散噪声、空间位置、局部图像内容和去噪状态。若强制这些 token 直接对齐预训练视觉模型的语义特征,它们就需要在生成动力学和表征学习之间折中,未必能成为稳定、纯净的语义载体。
AnchorDiT 为此引入一组不使用位置编码的 learnable registers,并在 Semantics Flow 第 8 个 block 处用 DINOv2 特征通过 𝓛REPA 进行监督。DINOv2 的稠密特征先被均匀池化到与 register 数量一致,再作为对齐目标。由此形成明确的职责分工:
- 大 patch token 继续负责空间布局、噪声状态和主干去噪;
- registers 专门吸收可迁移的稠密语义;
- Fine-grained Flow 通过 Anchor Connectors 同时获得空间上下文与较稳定的表征语义。
这也是本文对 register token 更有针对性的重新解释:registers 不再只是吸收异常激活的辅助 token,而被转化为显式语义载体。t-SNE 中,大 patch token 的分布较为纠缠,而 registers 呈现出更清晰的聚类分离;有无 registers 的定性样例也提示对象语义更明确、幻觉和结构伪影有所减少。这些可视化属于辅助机制证据,与下述定量消融相互印证。
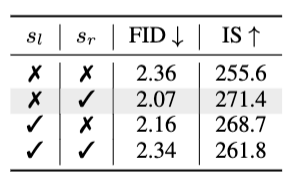
“仅监督 registers”明显优于同时监督两类 token,说明性能提升并非简单来自额外的特征损失,而是来自对表征语义与生成语义进行合理解耦。
register 数量实验还显示,0、4、16、64 个 registers 对应的 FID 分别为 2.19、2.15、2.07、2.09;16 个时达到最佳结果。这表明收益来自容量适中的专用语义通道,而不是无节制地增加 register token。
4. 与已有路线相比,新意在哪里?
AnchorDiT 的创新应从整体架构范式而非单个基础算子来理解:
|
路线 |
全局语义与细节的处理方式 |
主要局限或差异 |
|
单尺度 pixel-space DiT |
同一 patch 序列同时承担全局与局部建模 |
大 patch 损失细节,小 patch 的全局 attention 成本高 |
|
DDT 式多流结构 |
语义流与细粒度流仍使用大 patch |
对真实细粒度像素证据的保留有限 |
|
DeCo 式双分支结构 |
通过 AdaLN 条件调制注入语义 |
缺少细粒度 token 对多层语义 token 的显式、自适应查询 |
|
AnchorDiT |
大 patch 提炼多层 anchors,小 patch 通过 cross-attention 查询 |
同时配套跨尺度几何对齐和专门的稠密语义载体 |
围绕 granularity dilemma,论文给出了三个相互依赖的答案:
- 计算如何分工?——用短序列承担全局语义,用长序列承担局部细节;
- 两种尺度如何通信?——用多层 Anchor Connectors 建立内容自适应查询;
- 通信如何保持空间与语义可靠?——分别用 SA-RoPE 和 VFM-supervised registers 解决几何错位与表征纠缠。
这种“问题—机制—配套设计”之间的对应关系,使 AnchorDiT 的系统性创新清晰可辨。
5. 实验结果
所有主指标均在 ImageNet class-conditional generation 上使用 50K 样本评估:
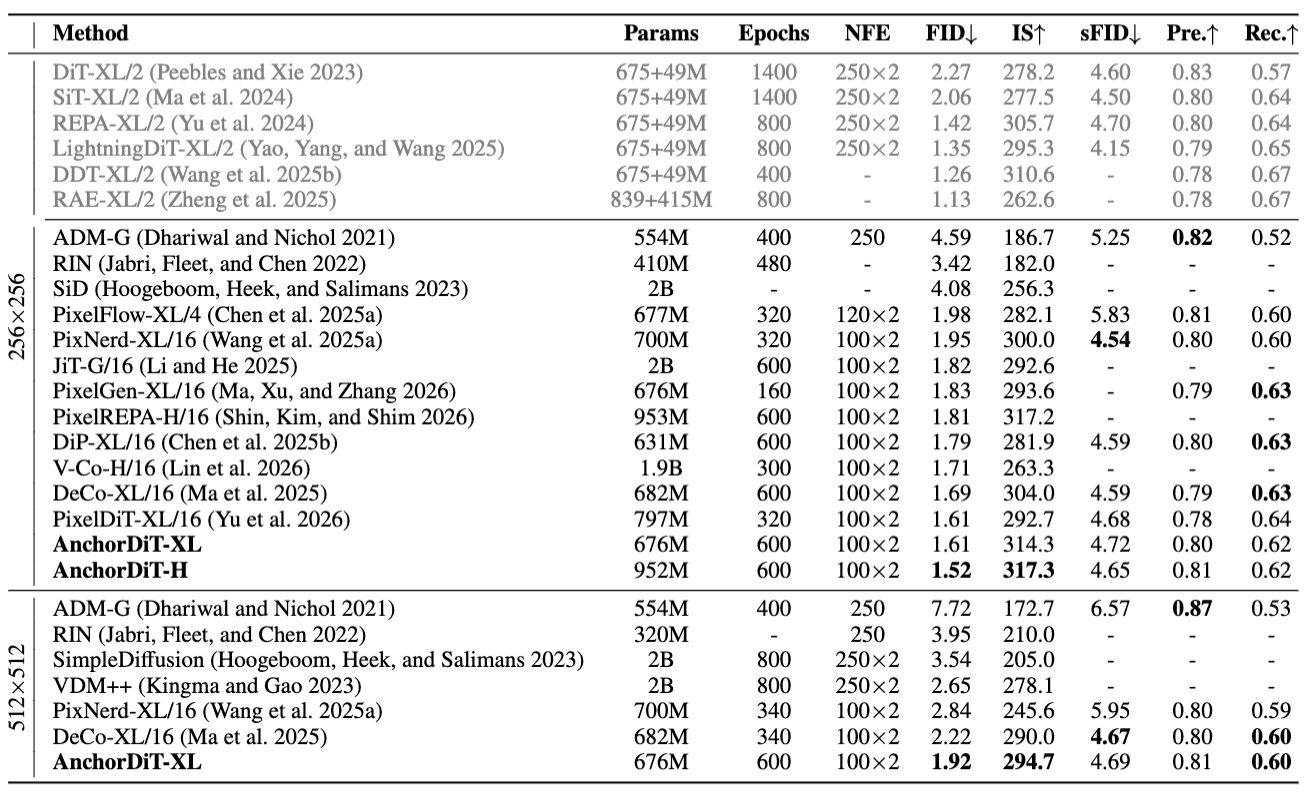
这些结果有四点值得重视:
- 匹配设置下的改进具有说服力。 在 256×256 上,AnchorDiT-XL 与 DeCo-XL/16 的参数量接近(676M 对 682M),训练轮数同为 600 epochs,采样预算同为 100×2 NFE;在这一可比设置下,FID 从69 降至 1.61,IS 从 304.0 提升至 314.3;
- 同规模 H 模型的优势突出。 AnchorDiT-H 与 PixelREPA-H/16 的参数量、训练轮数和 NFE 几乎完全匹配;前者将 FID 从81 降至 1.52,同时保持相当的 IS(317.3 对 317.2)。AnchorDiT-H 也取得论文所列像素空间方法中最佳的 256×256 FID;此外,AnchorDiT-XL 与 PixelDiT-XL/16 的 FID 同为 1.61,但 IS 更高(314.3 对 292.7);
- 高分辨率可行性得到支持。 AnchorDiT-XL 在 512×512 上达到 FID 1.92、IS 294.7,优于表中 DeCo-XL/16 的22 和 290.0。由于两者在该分辨率下分别训练 600 和 340 epochs,这组数字更适合作为高分辨率有效性证据,而不是严格同训练预算的归因比较;
- 生成路径不依赖 VAE/RAE 解码器。 结果直接在像素空间获得,不会额外继承图像自编码器的重建误差。DINOv2 仅在训练阶段为 registers 提供表征监督,不参与图像解码。
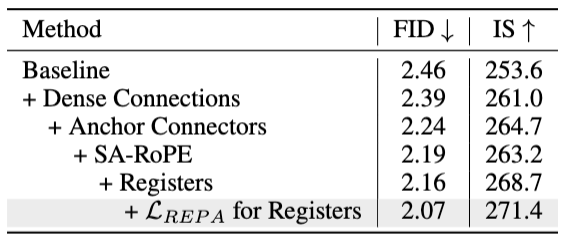
从 baseline 的 2.46 到完整配置的 2.07,FID 随组件加入以及 REPA 监督目标的调整逐步改善;连接器数量、register 数量、patch size 和 REPA 对齐对象还分别进行了专项消融。虽然 IS 并非在每一步都单调上升,但完整配置取得了最佳综合结果。这种实验组织方式能够把最终性能与论文提出的三项核心机制逐一对应起来,增强了方法解释的可信度。
6. 计算—质量权衡:以紧凑锚点组织全局交互
AnchorDiT 的效率目标,是避免在全部小 patch token 上进行完整的全局 self-attention,同时仍为每个细粒度 token 提供全局语义访问能力。以 256×256、大/小 patch size 为 16/8 的默认配置为例:细粒度分支包含 322=1024 个空间 token,而大尺度分支只有 162=256 个空间 token,外加 16 个 registers。让 1024 个 query 查询紧凑的 anchor 序列,显著小于在 1024 个细粒度 token 之间构造完整两两注意力。
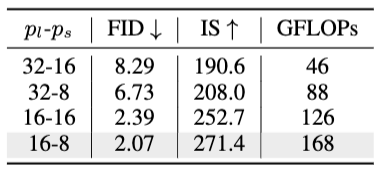
结果揭示了两个互补事实:语义 patch 不能过粗,否则锚点本身缺乏足够的结构信息;在语义尺度合理后,更细的生成 token 又能继续改善纹理和边界。默认 16/8 配置的 168 GFLOPs 约为 8/8 配置 533 GFLOPs 的三分之一,说明该设计有效控制了细粒度建模的计算增长;在具有完整质量指标的配置中,16/8 取得最佳综合结果。
7. 如何评价论文的研究贡献
从研究意义、创新性、技术合理性和实验验证四个维度看,AnchorDiT 的优势可以概括为:
- 研究意义明确: 直接面向像素空间生成中全局语义、局部细节和计算成本之间的核心矛盾;
- 核心洞见清晰: 将全局建模与细节生成分配给不同粒度的 token,再用语义锚定建立协作关系;
- 方法具有系统性: Anchor Connector、SA-RoPE 与 semantic registers 分别处理跨尺度交互、空间对齐和语义表征专门化,三者服务于同一技术主线;
- 证据链较完整: 同时覆盖两个图像分辨率、多个模型规模、主流像素空间基线、逐组件消融以及特征可视化;
- 结果具有竞争力: 在生成路径不使用图像自编码器的前提下,取得论文所列 pixel-space generation 方法中的领先 FID,并在 512×512 上显示出良好的高分辨率表现;
- 具备进一步扩展的潜力: 语义锚点与细粒度查询的分工并不依赖某个特定类别条件形式,可自然启发更高分辨率或更丰富条件控制下的像素生成研究。
本文的实验范围聚焦于 ImageNet 类条件生成,因此其结论应理解为对像素空间架构设计的集中验证,而不是对所有生成任务的全面覆盖。在这一明确范围内,主结果和消融实验较充分地支持了“多层语义锚定能够改善细粒度像素生成”这一主要假设。文本条件、更多数据分布、可变分辨率以及真实吞吐量可以作为后续扩展方向。
总体评价
AnchorDiT 提供了一种清晰且有启发性的像素空间生成范式:由紧凑语义序列承担全局建模,由高分辨率 token 保留局部表达,再通过几何对齐、内容自适应的查询连接二者。
其主要价值体现在三个层面:它准确提炼了 granularity dilemma 这一关键问题;提出了结构上相互配合的解决方案;并用强主结果和多维消融为该方案的有效性提供了充分支持。综合来看,AnchorDiT 是一项围绕像素空间 Transformer 计算组织方式展开的系统性工作,为兼顾全局一致性、局部保真度与可控计算成本提供了具有说服力的新路径。
内容中包含的图片若涉及版权问题,请及时与我们联系删除

评论
沙发等你来抢